Spring Boot·NestJS와 PostgreSQL로 API, 트랜잭션, 배포와 운영까지 맡아 온 백엔드 개발자입니다.
5인 팀 ERP에서 서버 공통 기반과 구매·Message → ERP 모듈을 만들었고, 1인 서비스에서 수집 배치·조회 API·운영을 맡았으며,
공공 포털 백엔드를 12개월간 유지보수했습니다. 중복과 경합은 잠금·조건부 UPDATE·unique 제약으로 막고, 동시 요청 테스트로 증명합니다.
팀 프로젝트포스코 K-뉴딜 아카데미2026.09 – 2026.105인, 서버 공통 기반, 구매·Message → ERPNestJS 12, Prisma 7, PostgreSQL(Supabase), Next.js 16, Jest, Vitest, GitHub Actions
FantaSteel ERP
포스코 K-뉴딜 아카데미 과정에서 5인 팀으로 만든, 원료 입고부터 제선, 제강, 연주, 열연, 출하까지 일관제철 공정을 다루는 철강 제조 협업 ERP입니다. 설계 문서와 ERD를 기준으로 서버 공통 기반을 세팅했고, 구매·MRP·조직·업무 알림·Message → ERP 모듈의 API와 동시성 처리를 맡았습니다.
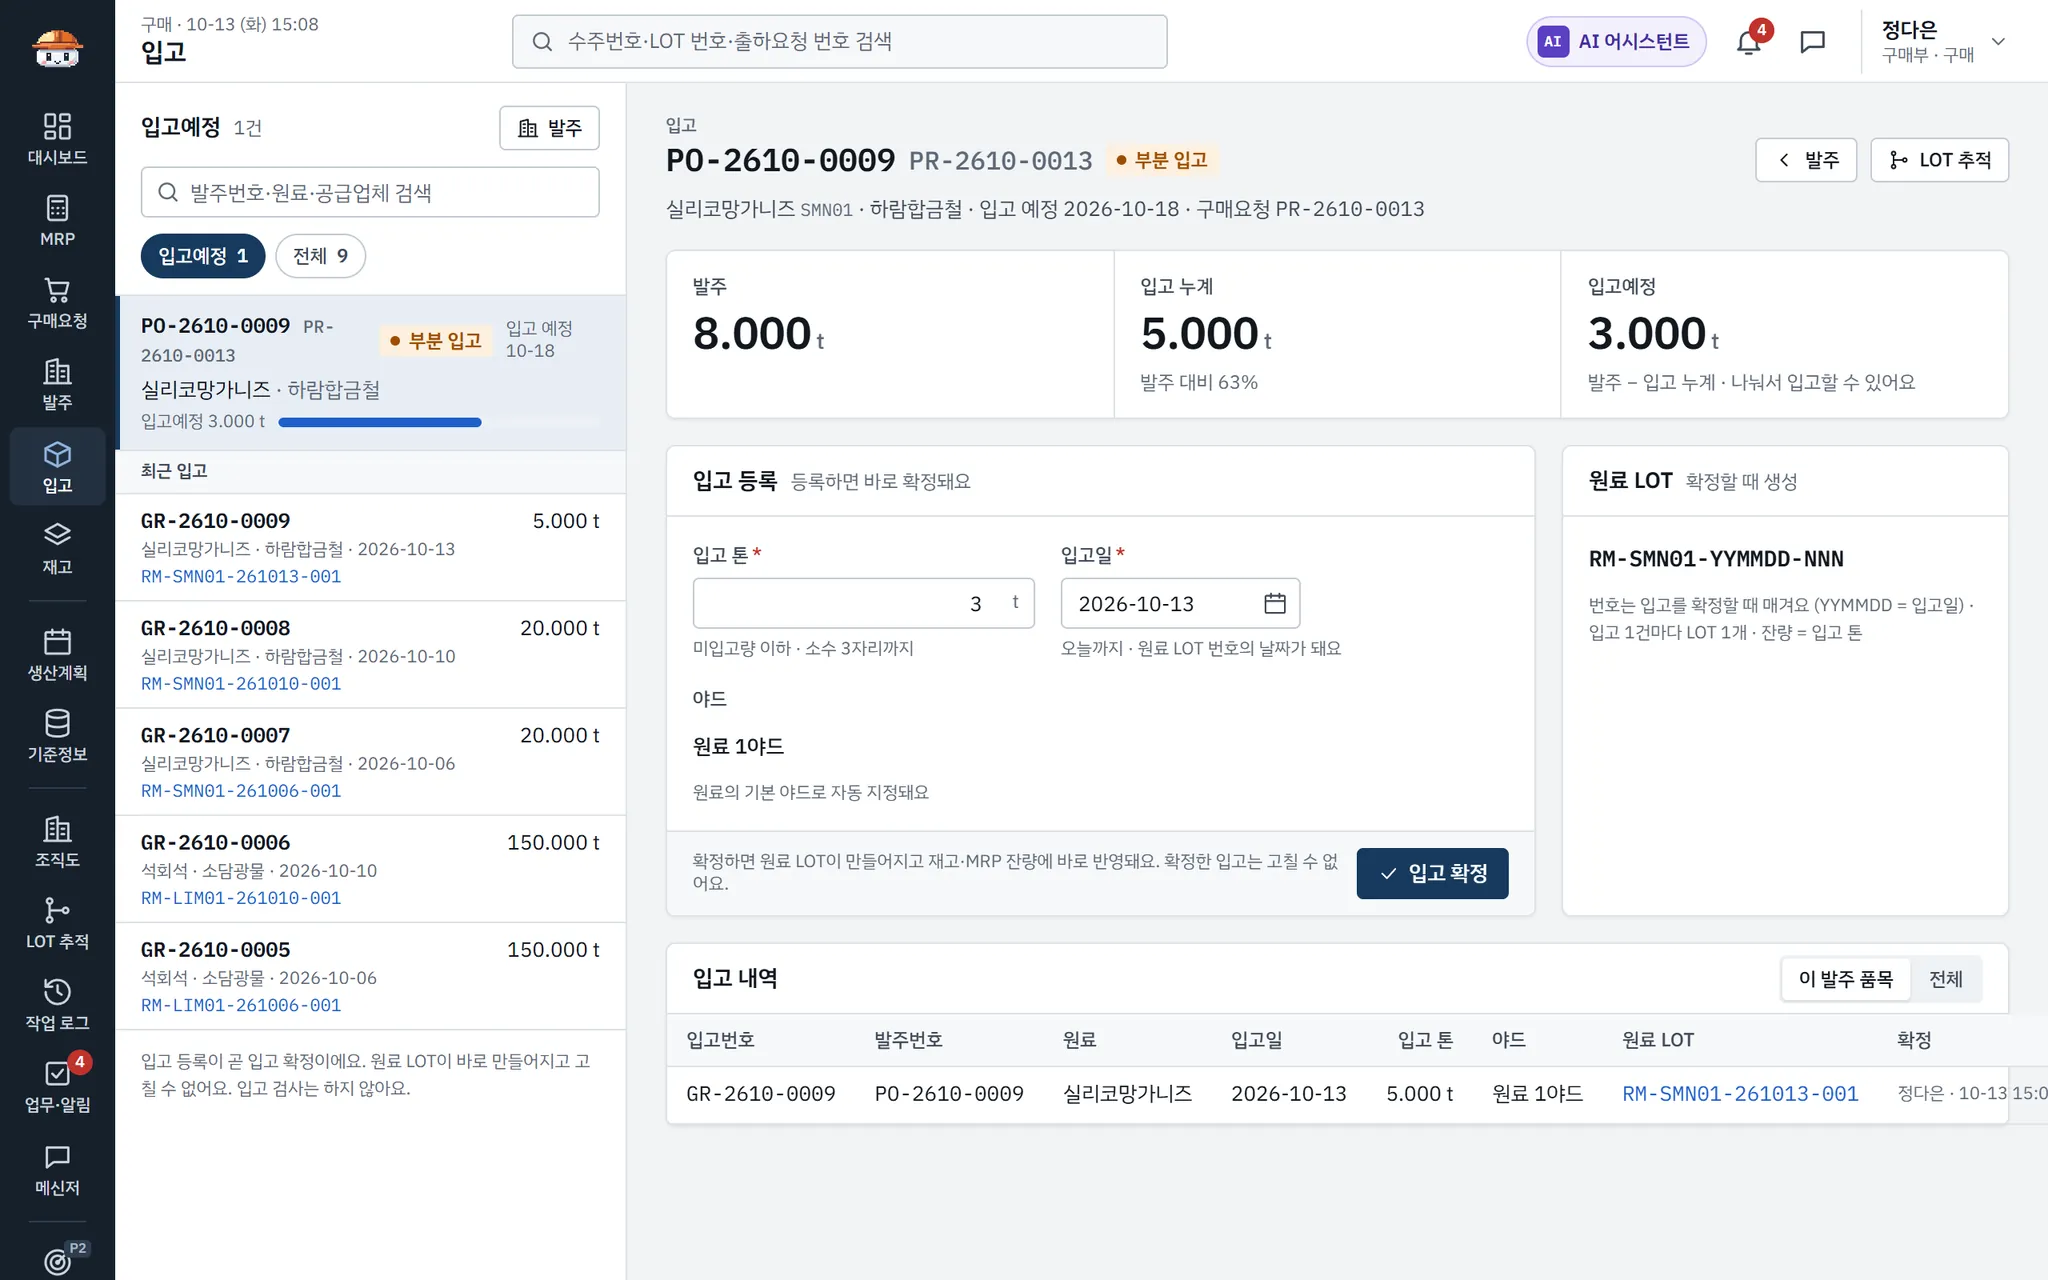
발주 8t 중 5t이 들어온 부분 입고 상태입니다. 입고를 확정하면 발주 행을 잠그고 미입고량을 다시 확인한 뒤 원료 LOT을 만듭니다.
/purchase-requisitions
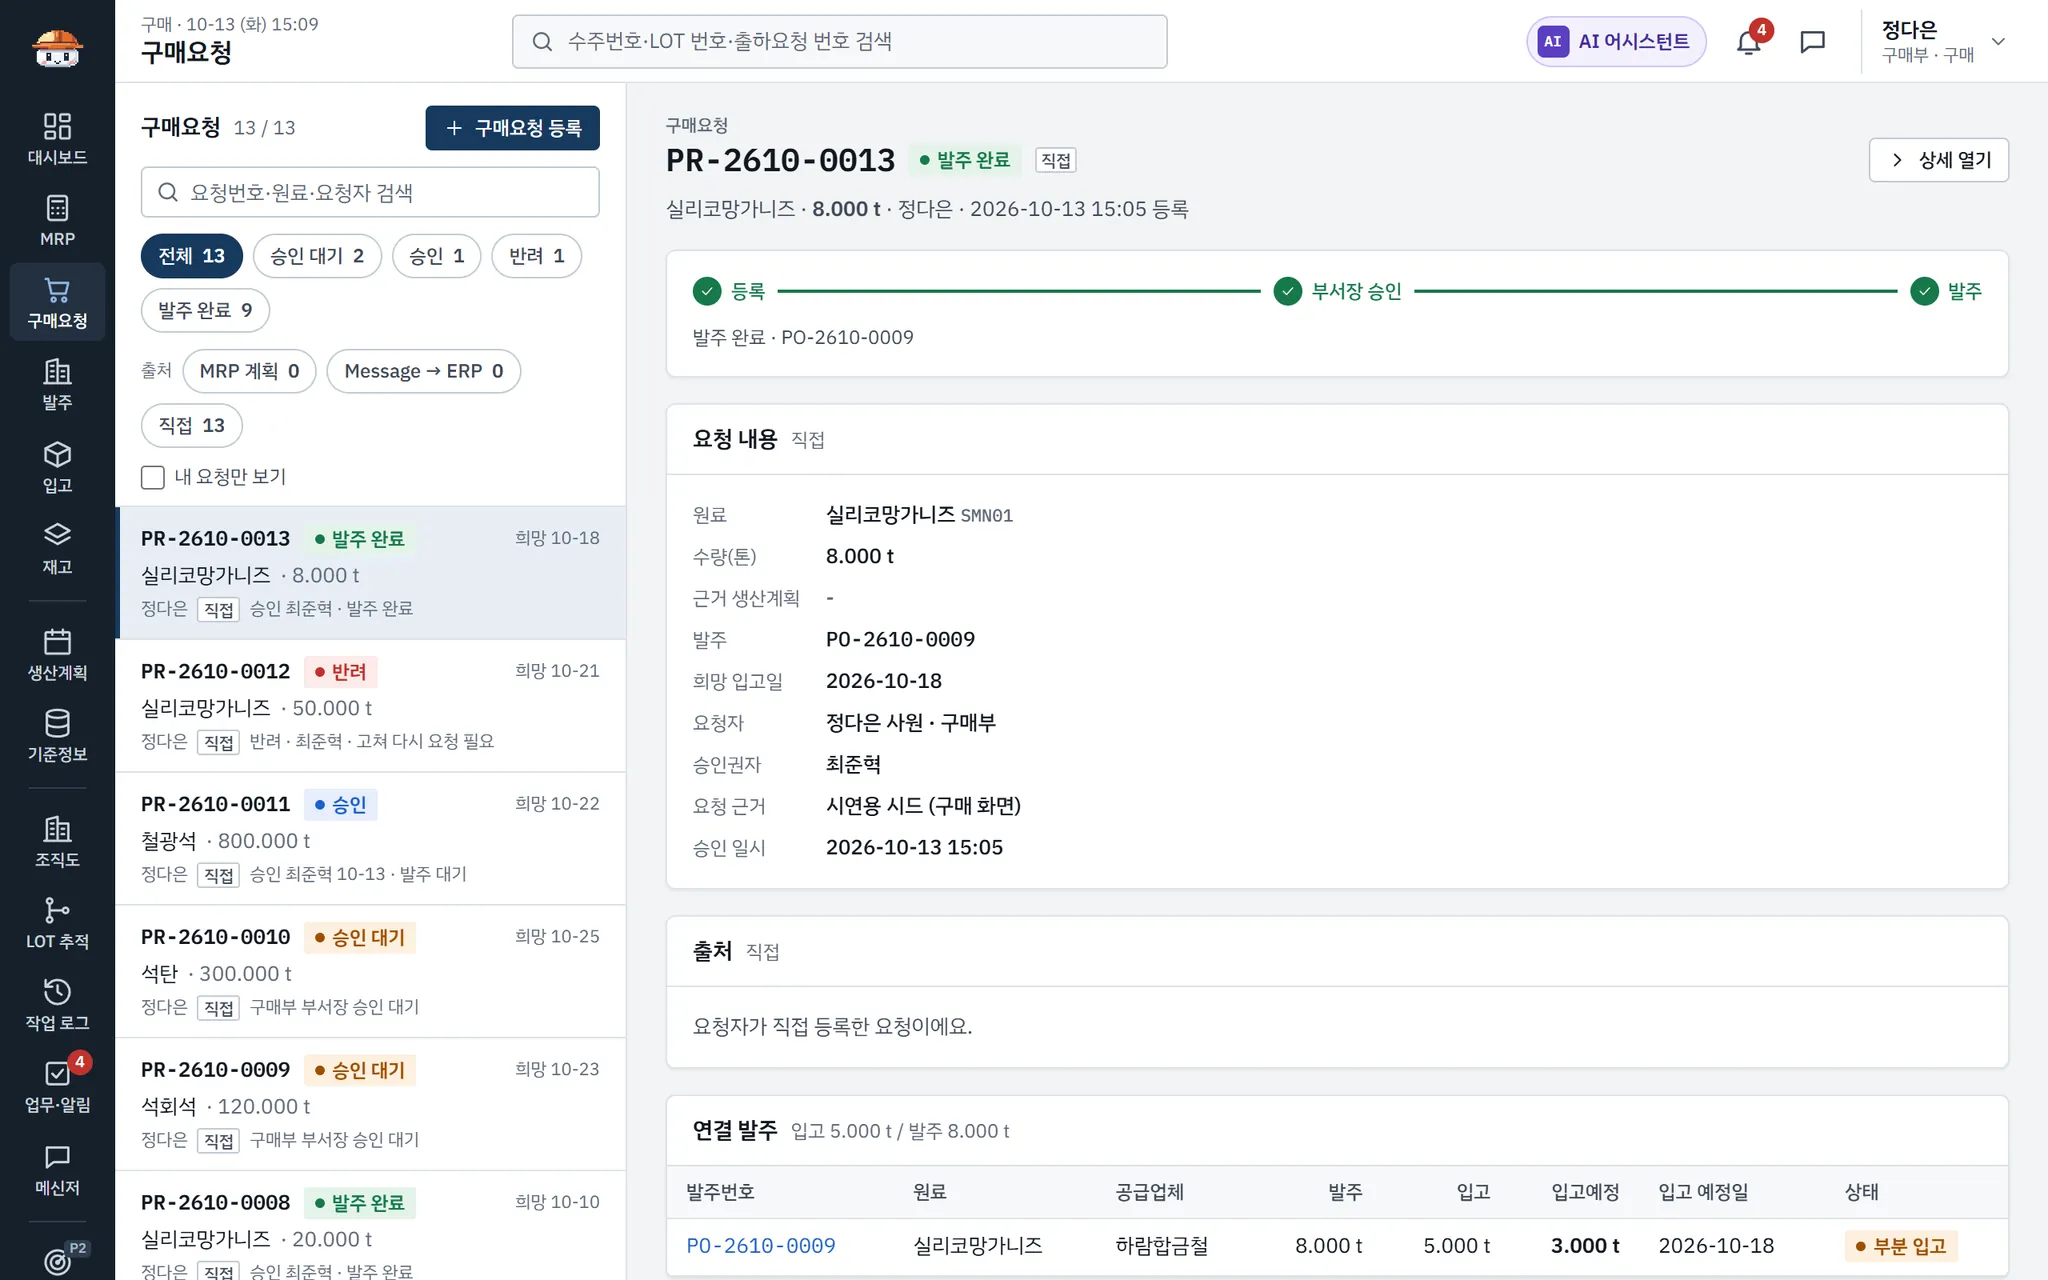
등록, 부서장 승인, 발주로 이어지는 상태 흐름입니다. 승인과 반려는 현재 상태가 기대한 상태일 때만 바꾸는 조건부 UPDATE로 처리합니다.
/mrp
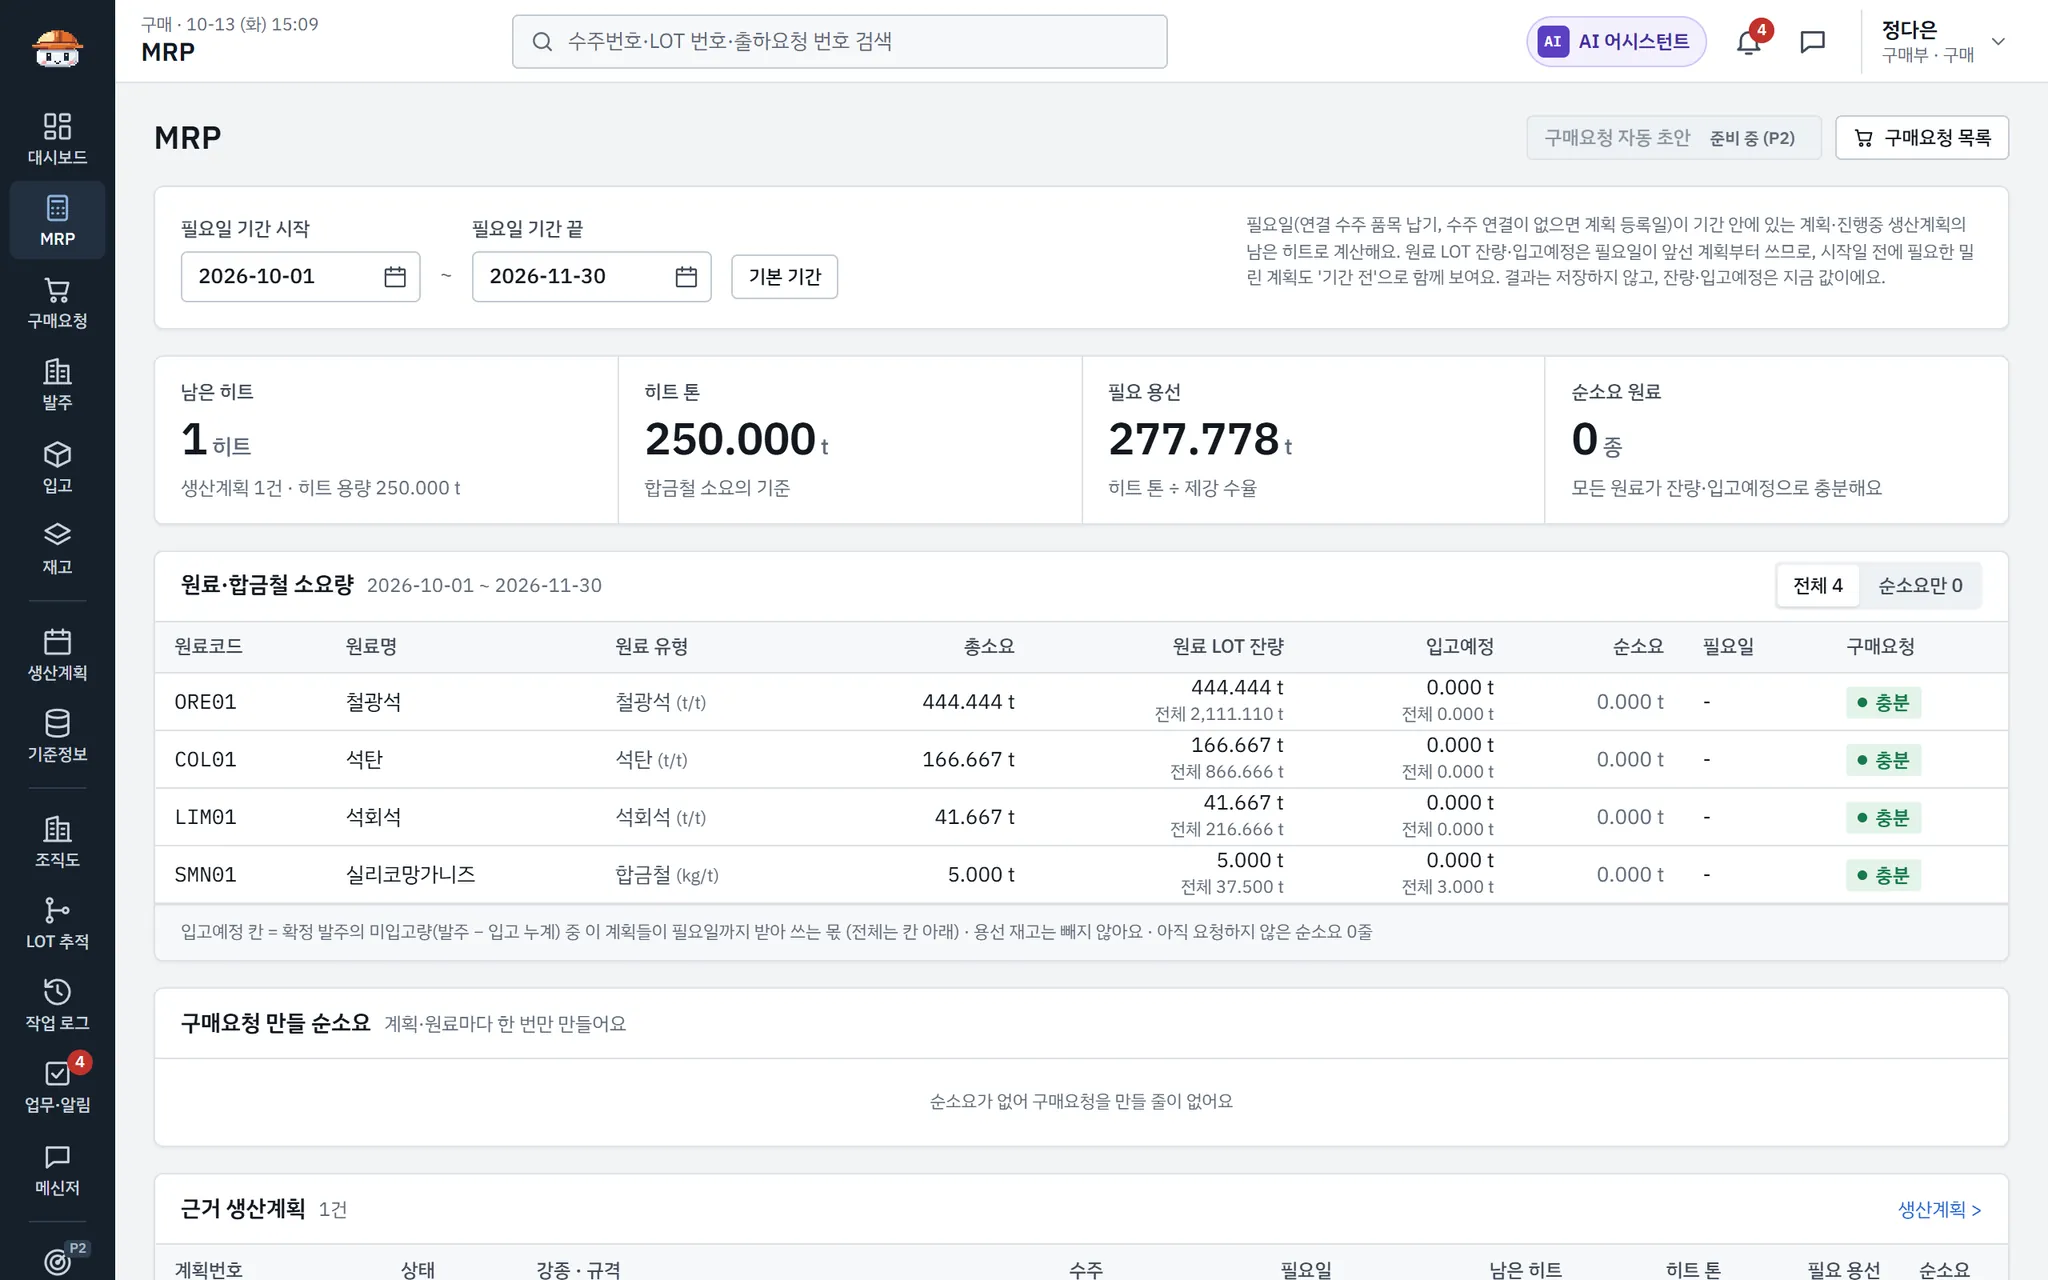
생산 계획의 히트 톤, 제강 수율, 원단위로 원료 소요량을 구하고, 원료 LOT 잔량과 입고 예정을 빼서 순소요량을 계산합니다.
/org-chart
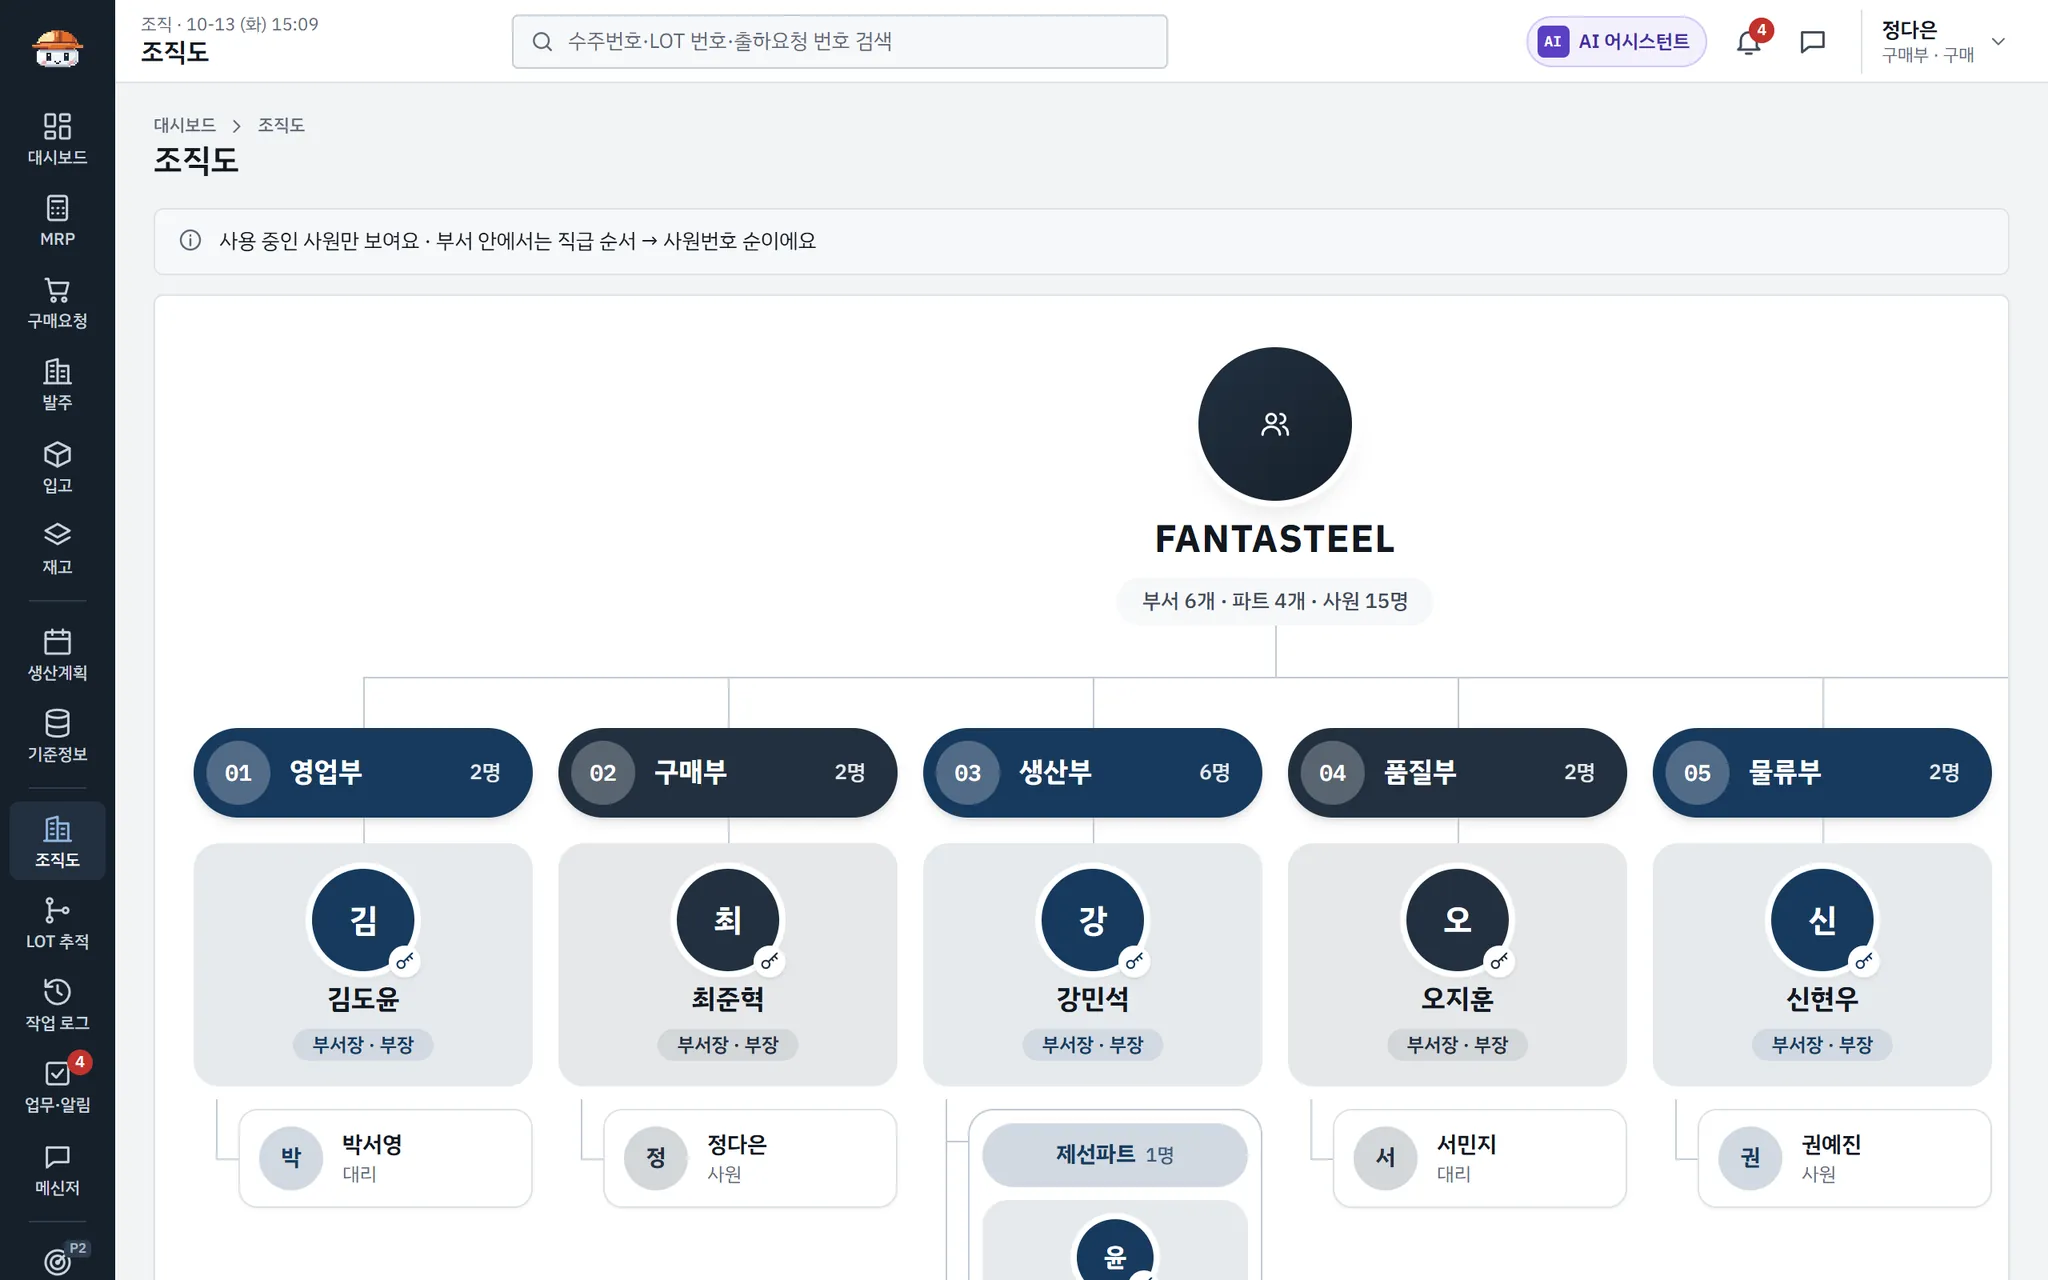
부서와 사원 구조입니다. 승인 권한은 권한 코드가 아니라 요청자 부서의 부서장인지로 판단합니다.
로컬 개발 환경에서 시드 데이터로 실행해 캡처했습니다. 제가 맡은 부분은 이 화면들이 쓰는 구매, MRP, 조직, 알림 API입니다.
GitHub 기록
110PR 작성
250PR 병합 담당(팀 전체 448)
8,472줄 가짜 DB 삭제
16개 PR로 화면 서버 전환
2026.10.27 기준입니다.
맡은 일
서버 공통 기반
ERD를 Prisma 스키마와 초기 마이그레이션(CHECK 제약, 부분 unique 인덱스)으로 옮기고 오류 처리, 응답 형식, 쿠키 인증, 권한 검사, 채번, 작업 로그 기록 공통 모듈을 만들었습니다. 팀원이 같은 기준으로 구현하도록 모듈별 구현 안내 문서 15개를 썼습니다.
직접 구현
구매(요청, 부서장 승인, 발주, 입고), MRP, 조직, 업무·알림, Message → ERP 모듈의 서버 API와 화면 연결.
화면 서버 전환
처음에는 화면이 브라우저 안 가짜 DB로 돌았습니다. PR 16개에 걸쳐 영역별로 실제 서버 API에 붙이고 가짜 DB가 검증하던 동작은 서버 DB 테스트로 옮긴 뒤, 가짜 DB(35개 파일, 8,472줄)를 지웠습니다.
협업
Git 흐름과 PR 규칙을 정하고 팀 PR 병합과 공용 DB 반영을 맡았습니다. PR마다 테스트를 뺀 변경 줄 수와 머지 순서를 적어 작게 나눠 올렸습니다.
설계 포인트
구매 데이터 모델
구매요청부터 발주, 입고, 원료 LOT, 작업 로그까지 이어지는 흐름을 테이블로 나눴습니다. 입고 한 건은 원료 LOT 하나를 만들고, 작업 로그는 LOT와 N:M으로 연결됩니다.
색칠한 테이블은 직접 구현한 구매·알림 모듈과 공통 작업 로그입니다.
초과 입고 방지
발주 상태(부분 입고, 입고 완료)는 같은 발주의 모든 품목 입고 합계로 정해집니다. 같은 발주의 다른 품목이 동시에 입고되면 각 거래가 상대 품목을 "아직 안 들어옴"으로 보고 잘못된 상태를 저장할 수 있었고, 같은 품목이면 미입고량을 넘겨 입고될 수 있었습니다. 그래서 잠금 대상을 발주 품목이 아니라 상위 발주 행으로 정하고(TypedSQL SELECT … FOR UPDATE), 확인부터 기록까지 한 트랜잭션으로 묶었습니다.
같은 품목에 60t를 동시에 두 번 입고하면 하나만 성공하고 다른 하나는 PUR-003으로 롤백되며 원료 LOT도 하나만 생기는 것을 테스트로 고정했습니다. 버튼을 두 번 누르는 경우까지 막도록 수주 모듈의 멱등 키 저장소를 공통 모듈로 옮기자고 팀에 제안했습니다.
요청 A60t 입고준비
요청 B60t 입고준비
발주 100t 중 미입고100t원료 LOT0개
하나의 트랜잭션
발주 행 잠금FOR UPDATE
미입고량 확인초과면 거부
입고 저장원료 LOT 생성
발주 상태 갱신부분, 완료
작업 로그알림 기록
같은 발주 품목에 60t 입고가 동시에 두 번 들어온 경우입니다.
상태 전이
승인, 반려, 재요청은 "현재 상태가 기대한 상태일 때만" 바꾸는 조건부 UPDATE로 처리해, 동시에 들어와도 한쪽만 반영됩니다. 여러 구매요청으로 발주를 만들 때는 id 순서로 잠가 교착을 피했습니다.
알림의 원자성
작업 로그와 알림을 본 거래와 같은 트랜잭션에서 기록해, 거래가 롤백되면 알림도 남지 않게 했습니다. 중복 알림은 부분 unique 인덱스로 막았습니다.
MRP 계산
생산 계획의 히트 톤, 제강 수율, 원단위로 원료 소요량을 구하고, 원료 LOT 잔량과 입고 예정을 빼 순소요량을 계산합니다. 같은 공급을 두 계획에서 중복으로 빼지 않도록 공급 사용 순서를 정했고, Decimal로 계산한 뒤 마지막에 한 번만 반올림합니다.
권한
승인은 권한 코드가 아니라 요청자 부서의 부서장인지로 판단하고, 본인 요청은 승인할 수 없게 했습니다. 권한은 요청마다 DB에서 다시 읽어 변경이 바로 반영됩니다.
Message → ERP
기능
채팅 메시지에서 구매요청 초안을 만들고, 요청자가 확정하면 실제 구매요청을 만드는 기능입니다. 서버 API와 화면을 만들었고, 이후 LLM이 메시지에서 초안 칸을 채우도록 넓혔습니다. POST messages/:id/action-drafts, POST action-drafts/:id/confirm
초안 만들기
외부 LLM 호출은 느리고 실패할 수 있어 DB 트랜잭션 밖에서 부르고, 호출 전과 트랜잭션 안에서 같은 조건을 두 번 확인합니다.
확인 ①방 참여자, 확정자 권한, 미처리 초안
LLM 추출트랜잭션 밖, 30초 제한, 실패하면 빈 초안
서버 재검증원료 1개 일치, 톤 > 0, 날짜 형식
확인 ② + 저장한 트랜잭션에서 확인 대기로 저장
확정과 실행
구매요청 생성은 승인권자가 없거나 채번이 겹치면 실패할 수 있습니다. 확정을 먼저 커밋하고 실행은 다른 트랜잭션으로 나눠, 실행이 실패해도 확정은 남고 다시 실행할 수 있게 했습니다.
트랜잭션 1APPROVED, 확정 로그
트랜잭션 2구매요청 생성, EXECUTED, 실행 로그
실패하면트랜잭션 2만 롤백, 오류 코드·시도 횟수 기록
다시 실행POST …/execute
중복 실행 방지
상태 확인, updatedAt 조건 갱신, 결과 구매요청의 action_draft_id unique 제약 세 겹으로 막았습니다. 같은 메시지·유형의 미처리 초안은 부분 unique 인덱스로 하나만 둡니다. 다시 확정·실행해도 구매요청은 1건만 생기는 것을 테스트로 확인했습니다.
업무 유형 등록부
유형마다 확정자, 필요한 권한, 칸 해석, 실행 방법을 정의 하나로 등록하는 구조로 바꿔, 수주·출하요청 같은 새 유형은 정의 하나만 더하면 붙게 했습니다. AI에는 DB 쓰기 권한을 주지 않고 실행은 사용자 권한과 업무 검증을 거칩니다.
AI 경유 기록
AI가 채운 칸 이름을 초안에 남기고(사람이 고쳐도 유지), 그런 초안의 확정·실행 작업 로그는 AI 경유로 표시해 나중에 추적할 수 있게 했습니다.
해결한 문제
advisory lock
동시 거래의 작업 로그 번호가 겹쳐 거래 전체가 실패하던 문제
번호 앞부분을 트랜잭션 잠금으로 묶어, 동시에 기록해도 두 거래 모두 저장
문제
채번은 "같은 앞부분의 최댓값 + 1"이라 거의 모든 거래가 남기는 작업 로그 번호(EV-)가 두 거래 사이에서 겹칠 수 있었습니다. 겹치면 unique 위반으로 본 거래 전체가 실패했고, 재시도가 있던 구매·수주와 달리 출하·품질·재고·생산은 그대로 실패했습니다.
해결
최댓값을 읽기 전에 번호 앞부분을 pg_advisory_xact_lock(hashtext(prefix))로 잠가, 뒤 거래가 앞 거래의 커밋을 기다린 뒤 다음 번호를 받게 했습니다. 잠금은 커밋·롤백 때 함께 풀립니다.
업무 번호(수주·생산계획·구매요청·발주·입고·출하요청·작업 로그)와 LOT 번호를 모두 같은 공통 채번으로 처리합니다.
잠금이 거래 끝까지 유지돼 생길 수 있는 교착 관계를 따져, 기존 unique 인덱스 대기와 같은 관계라 새 위험이 아님을 PR에 남겼습니다.
결과
앞 거래가 커밋하기 전에 뒤 거래가 기록해도 두 거래 모두 저장되고 번호가 이어지는 테스트를 만들었고, 잠금을 빼면 이 테스트가 unique 위반으로 실패하는 것을 확인했습니다. 병합 전 로컬 리뷰에서 sleep으로 순서를 맞춘 테스트가 가끔 실패한다는 지적을 받아 신호로 순서를 정하게 고쳤습니다.
트랜잭션
경고 5건 뒤에 있던 쿼리 겹침 789회
경고는 5건이었지만 실제 겹침은 789회, 겹침을 세는 테스트로 0회 고정
문제
테스트에서 pg 드라이버 경고 client is already executing a query가 나왔습니다. 다음 메이저 버전에서는 오류로 바뀌는 경고였습니다.
원인
Prisma 트랜잭션 안에서 include로 여러 관계를 한 번에 읽으면, 하나의 연결에 쿼리가 동시에 들어갔습니다. 경고는 테스트 파일마다 한 번만 찍혀 5건으로 보였지만, 쿼리 호출을 가로채 세어 보니 실제로 겹친 횟수는 789회였습니다.
해결
트랜잭션 안에서는 관계를 하나씩 읽고, 응답 모양을 만드는 조회는 커밋 뒤로 옮겼습니다.
결과
겹침 조건을 직접 세는 테스트(수정 전 51회로 실패, 수정 후 0회)로 고정했고, 같은 원인이 있는 다른 모듈의 위치를 표로 정리해 팀에 공유했습니다.
팀 개발 환경
병합 전 변경이 공용 DB에 들어갈 위험
로컬 DB에서만 마이그레이션과 시드가 돌도록 막고, 공용 DB 반영은 명령 하나로
문제
개발 서버 실행 명령이 DATABASE_URL이 가리키는 DB에 마이그레이션과 시드를 자동으로 실행해, .env를 공용 DB로 바꾼 사람이 병합 전 브랜치에서 서버를 켜면 그 변경이 팀 공용 DB에 들어갈 수 있었습니다.
해결
대상 DB가 로컬인지 판정하는 스크립트로 마이그레이션과 시드를 감싸고, 공용 DB 반영은 develop 브랜치, 깨끗한 작업 트리, 원격과의 일치를 확인하는 명령(db:deploy) 하나로만 하게 했습니다.
결과
원격 주소로 실행하면 막히는 것을 확인했고, 그 과정에서 로컬(PostgreSQL 18)과 공용 DB(17)의 버전 차이를 찾아 리뷰 체크리스트에 넣었습니다.
스키마 변경과 데이터 검증
NOT NULL 칸 추가
기존 행이 있는 업무 테이블에 필수 칸(등록자)을 더할 때, 바로 NOT NULL로 추가하는 자동 생성 마이그레이션 대신 빈 칸 허용으로 추가, 기존 행을 담당자로 채움, NOT NULL 순서로 나눴습니다. ERD와 용어 사전을 먼저 고친 뒤 반영했습니다.
업무 불변식 점검
입력 검증이 빠졌던 동안 들어간 데이터를 찾으려고, 재고 수량과 LOT 수, 예약 합계와 주문 수량, 히트 톤과 용량, 설비 작업 시간 겹침 같은 11가지 규칙을 SELECT만으로 점검하는 스크립트를 만들었습니다. 위반이 있으면 종료 코드 1을 냅니다. 공용 DB에서 투입 순서 위반 20건과 설비 시간 겹침 61쌍을 찾았습니다.
운영 이력 시드
발표·시연용으로 3주치 거래·협업 이력을 넣는 시드를 만들었습니다. 전역 시계를 바꿔 실제 서비스 코드를 날짜 순서대로 불러, 생성 시각과 날짜가 들어간 번호까지 그 시점으로 남깁니다. 넣은 뒤 불변식 11개와 참조 관계 99개 점검을 위반 0으로 통과했습니다.
CI와 배포
CI
PR마다 GitHub Actions가 PostgreSQL 17 서비스에 마이그레이션을 적용하고 타입 검사, 서버 단위 테스트, 화면 테스트, 서버 DB 테스트 7묶음을 돌립니다. 손으로 돌리던 검사를 빠뜨려 develop이 깨지던 일을 막으려고 만들었습니다.
자동 배포
main 병합 때 러너가 Tailscale로 사설망에 들어가 EC2에 SSH하는 배포 워크플로를 만들었습니다(SSH 포트는 밖에 열지 않음). 배포 스크립트는 반영되지 않은 마이그레이션이 있으면 멈추고, 빌드 뒤 pm2 reload와 헬스 확인까지 합니다. 사설망 설정 뒤 첫 실행을 앞두고 있습니다.
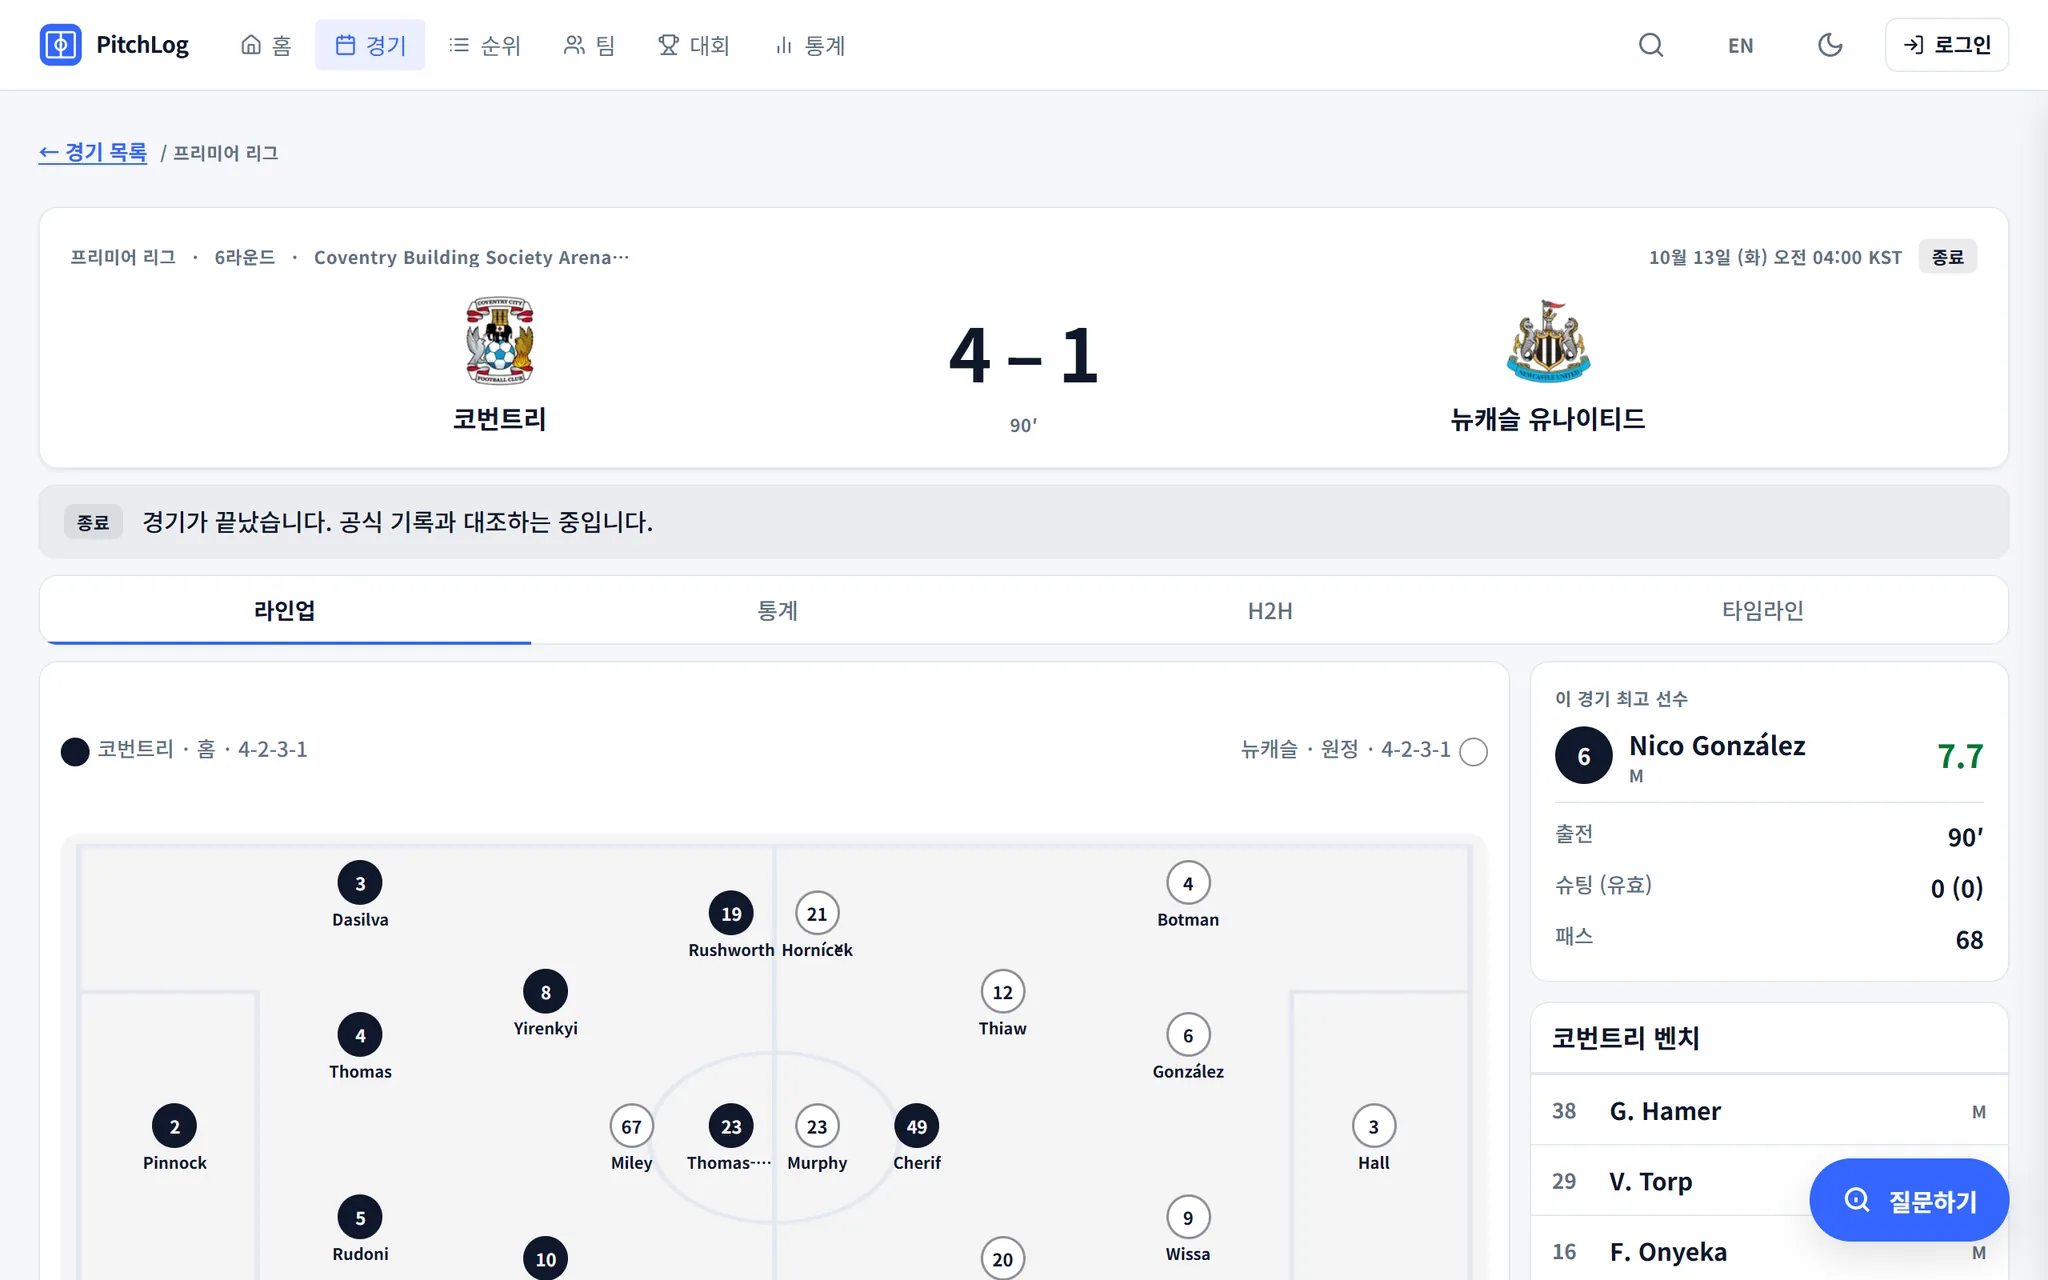
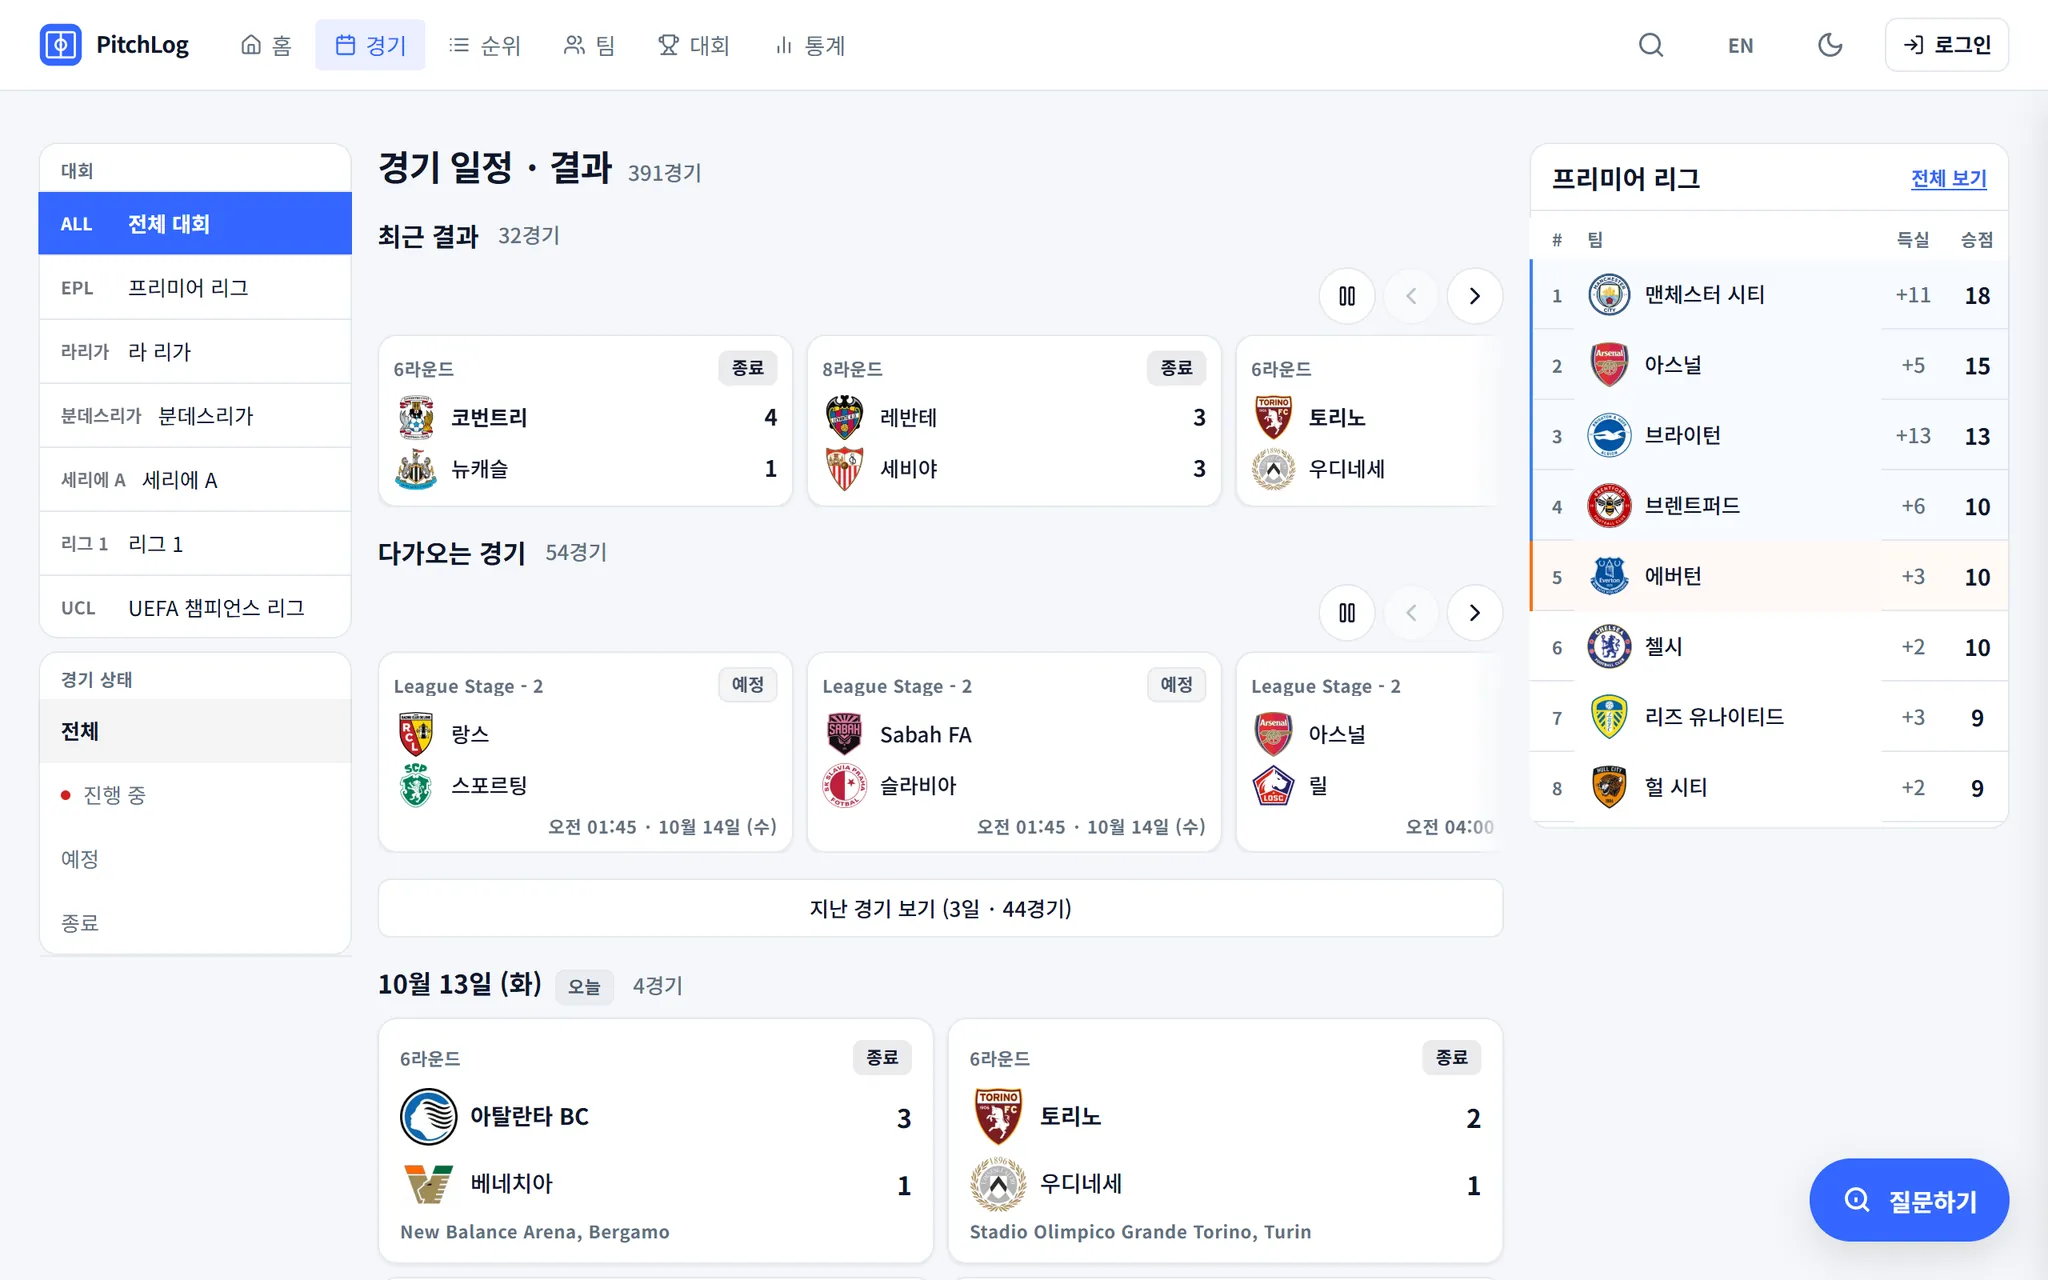
라인업, 경기 통계, 타임라인은 경기 상세 백필로 채운 데이터입니다. 진행 중인 경기를 15초 주기로 갱신하는 폴러를 만들었고, 이전 상태로 되돌아가는 쓰기는 조건부 UPDATE로 막습니다.
/matches
19개 대회의 일정과 결과를 대회와 경기 상태별로 봅니다. 외부 API 호출은 모두 한 클래스를 거치고, 분당 자체 상한을 넘지 않게 제한됩니다.
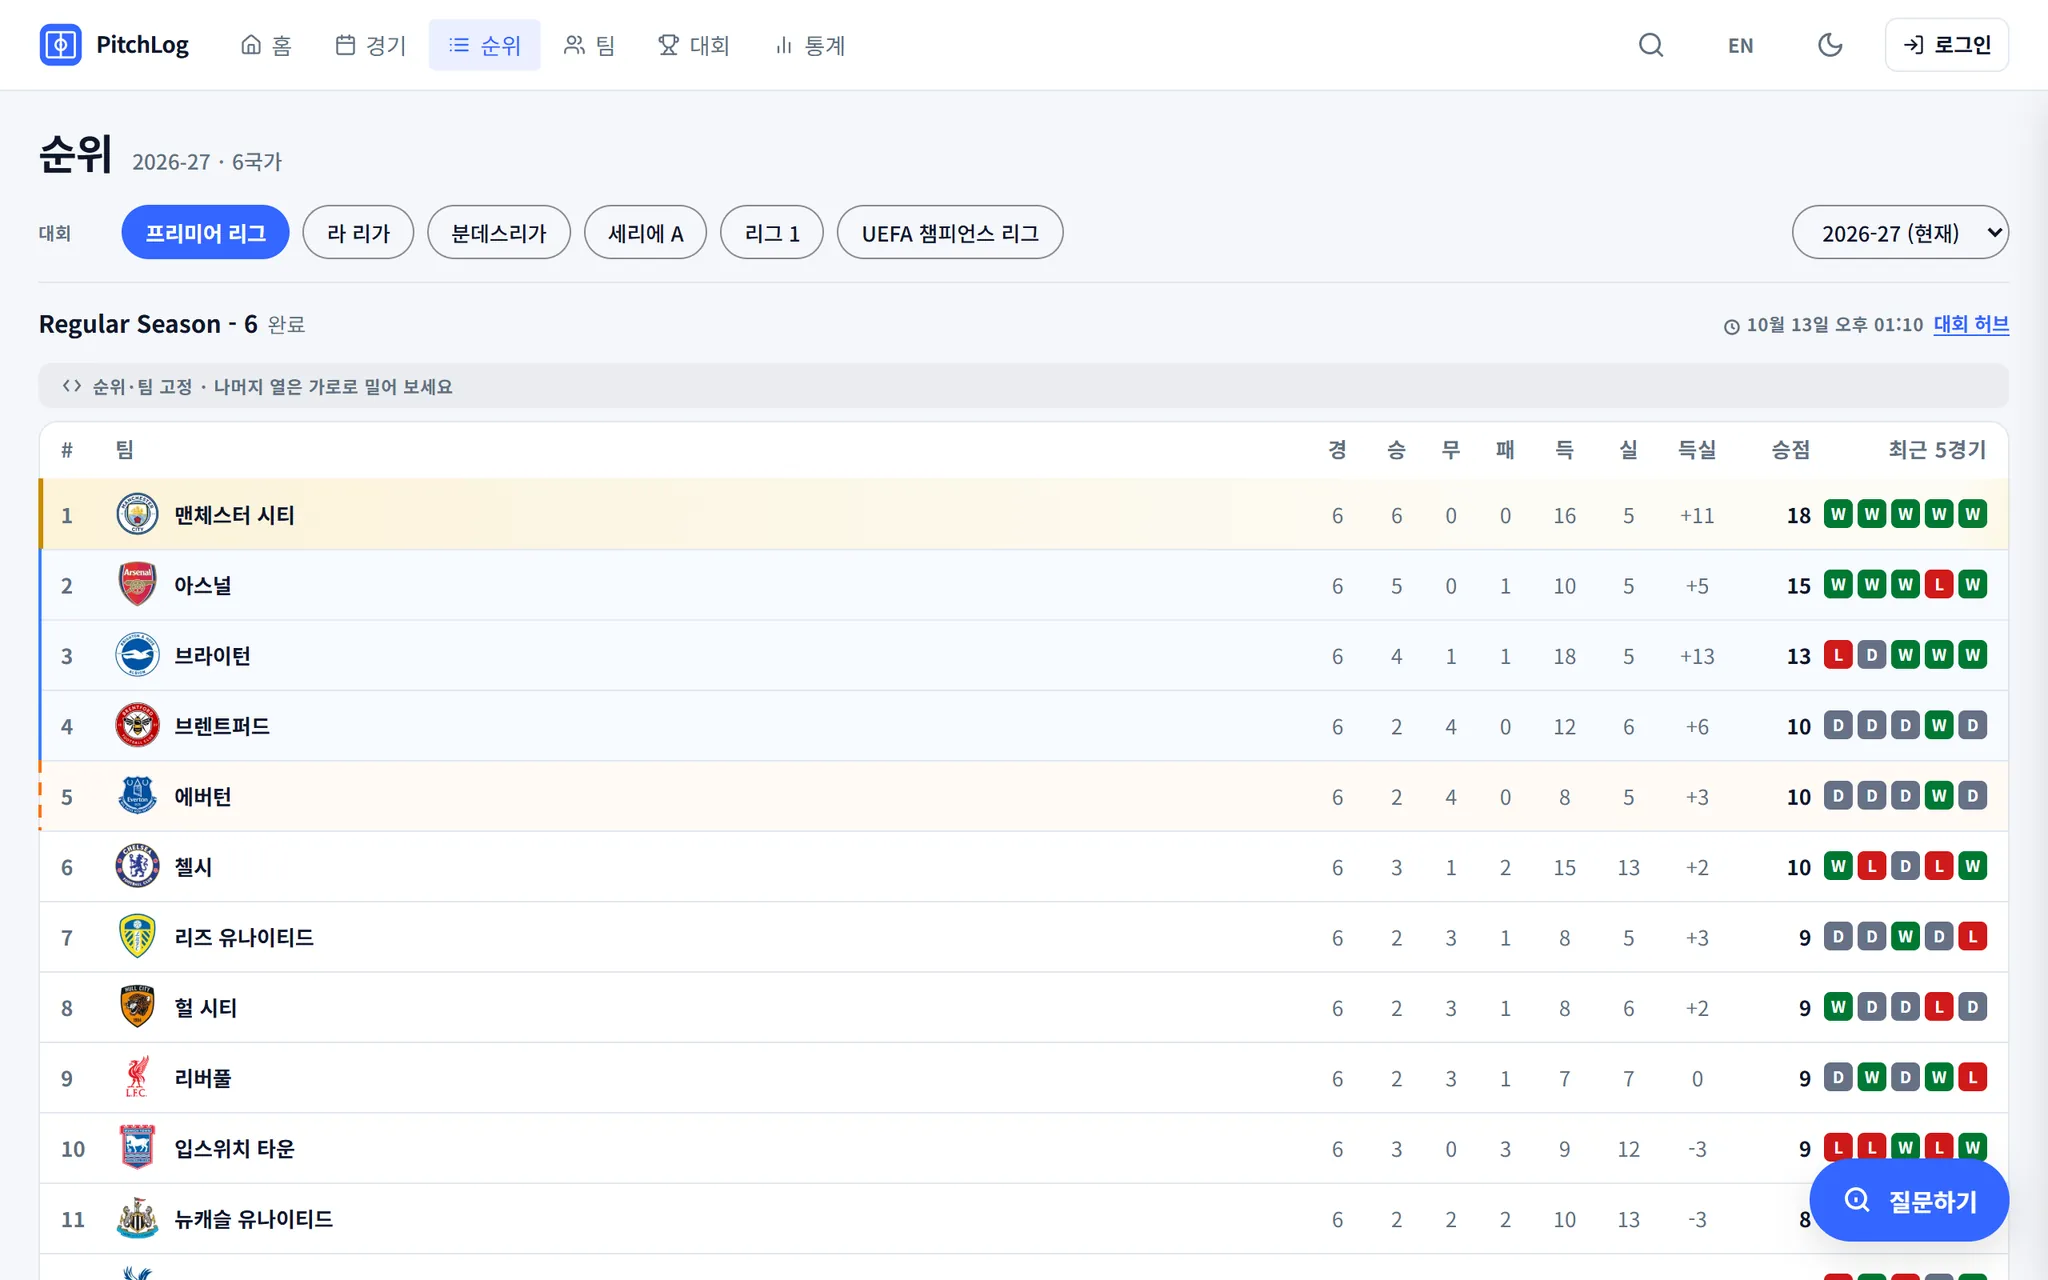
/standings?competition=premier-league
대회와 시즌별 순위표입니다. "대회당 현재 시즌은 하나" 같은 규칙은 부분 unique 인덱스로 DB가 지킵니다.
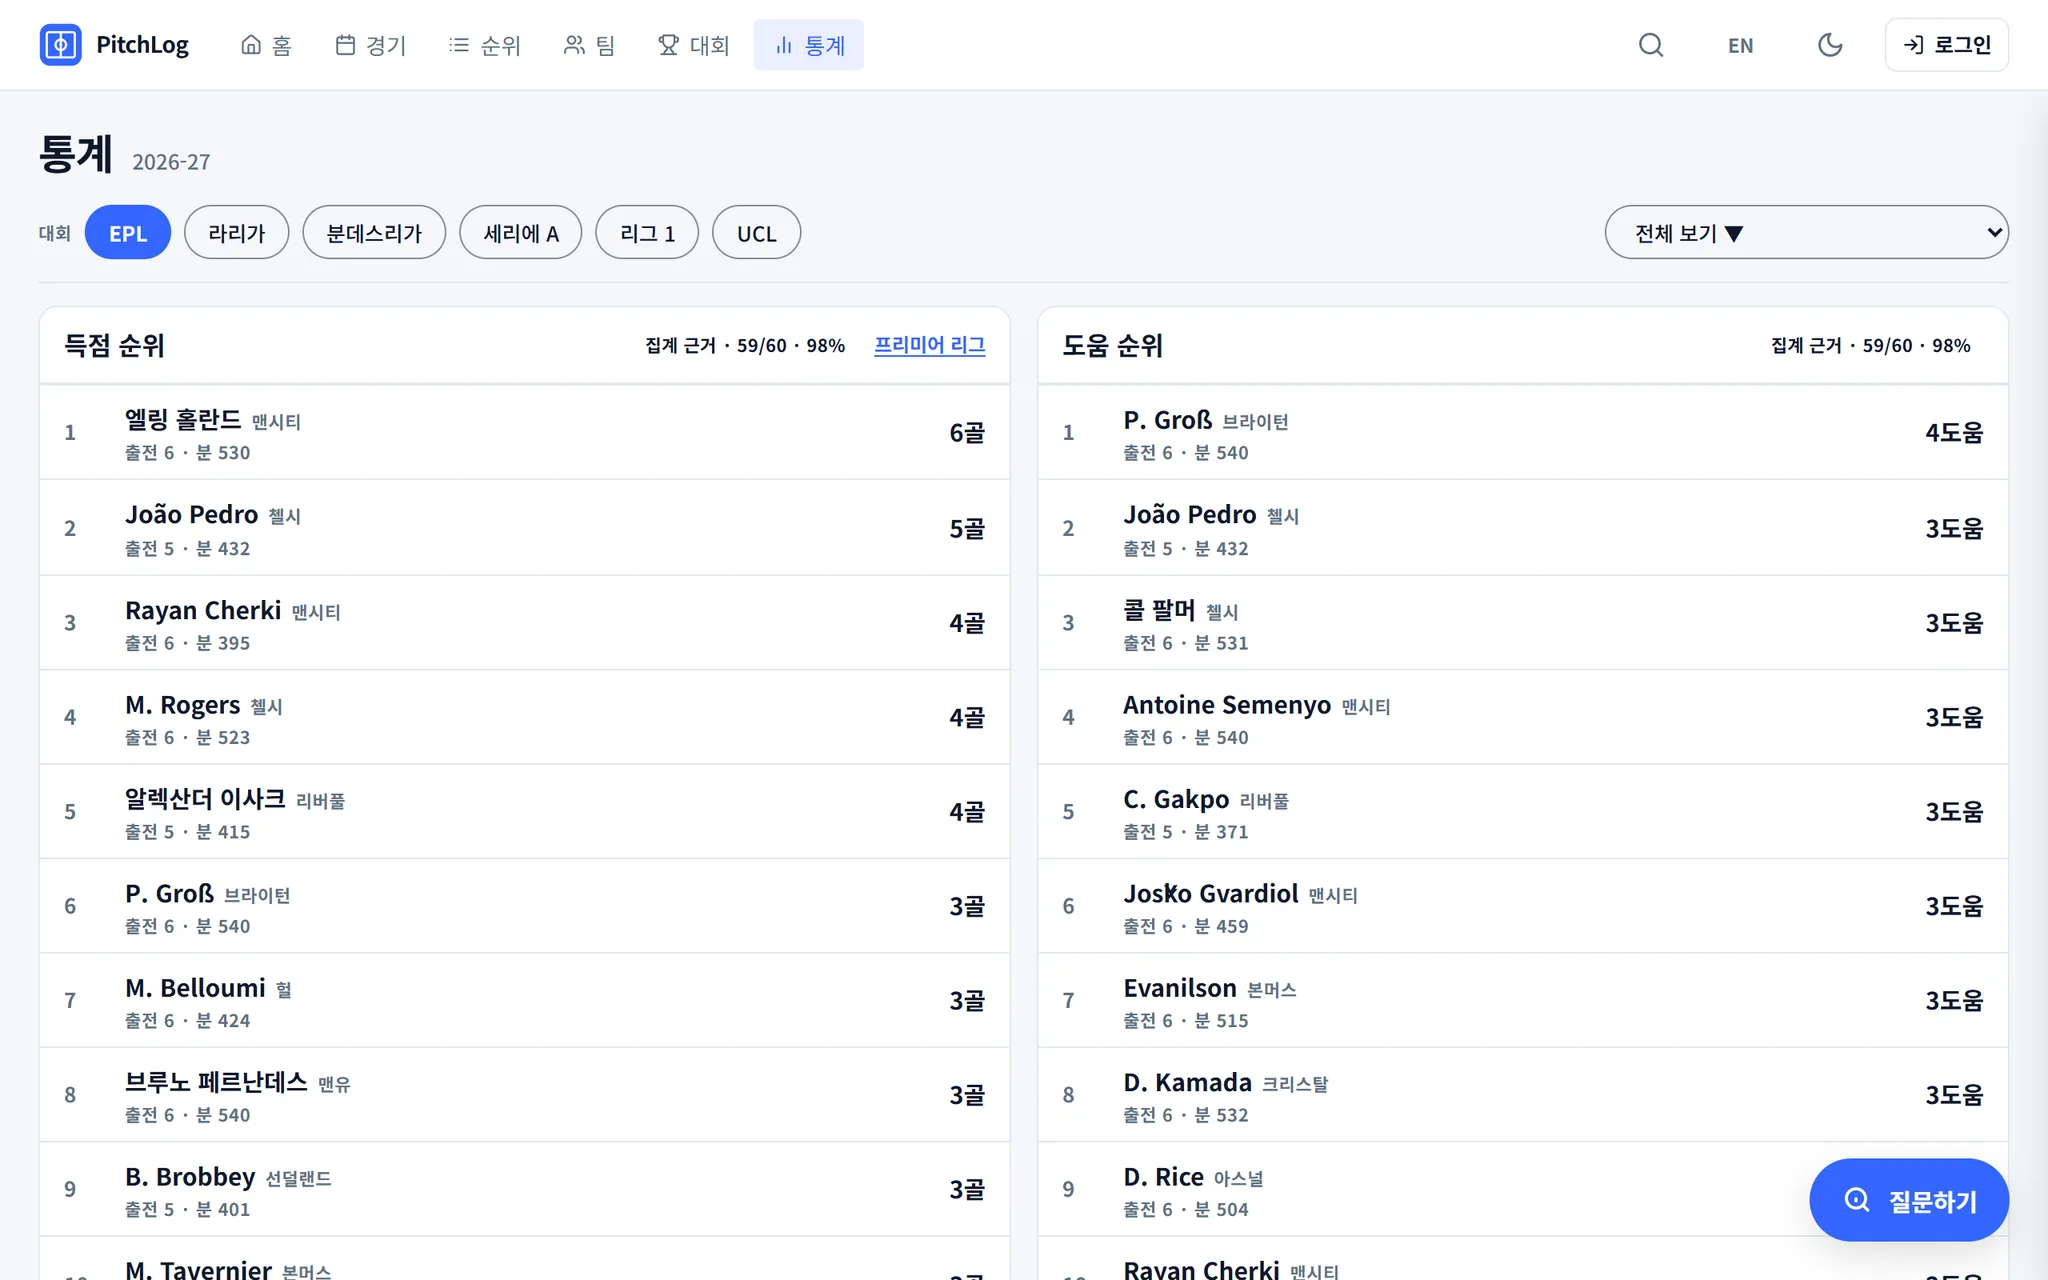
/stats?competition=premier-league
대회별 득점, 도움 순위입니다. 오른쪽 아래 "질문하기"는 AI 어시스턴트로, 숫자를 직접 만들지 않고 서버의 결정적 도구만 호출합니다.
2026년 10월 13일 실제 서비스에서 캡처했습니다. 화면을 누르면 크게 볼 수 있습니다.
규모
13,724경기
2,110팀
13,608선수
148PR
약 500백엔드 테스트
데이터 수치는 2026.09.17 실측입니다.
데이터 수집 경로: 스케줄러 잡이 수집 계층을 깨우면 API 클라이언트가 외부 API를 호출하고, 받은 데이터를 PostgreSQL에 배치 upsert합니다.
핵심 설계 결정
외부 API 보호
외부 호출을 한 클래스(ApiFootballClient)로 모으고 10초 제한 시간, 분당 자체 상한, 네트워크 오류·429·5xx에만 1, 2, 4초 간격 재시도를 걸었습니다. 응답이 200이어도 오류 필드가 있으면 실패로 처리하고, 하루 한도에 닿으면 즉시 멈춰 '조용한 실패'를 막았습니다.
큐 없는 백필
약 4만 3천 콜 규모의 경기 상세 백필을 메시지 큐 대신 backfill_jobs 테이블의 커서와 단일 루프로 처리했습니다. 하루 자율 상한(환경변수, 기본 5,700콜)과 중단 사유를 기록해 멈춘 지점부터 이어 가고, 라이브 수집은 백필이 끝난 뒤 켜서 같은 한도를 두고 다투지 않게 했습니다.
DB 설계
"대회당 현재 시즌은 하나" 같은 규칙은 부분 unique 인덱스로 DB에서 강제했습니다. 대량 적재 속도를 위해 외래 키를 두지 않는 대신 참조 컬럼 인덱스 69개와 고아 행 검사(CI, 매일)로 무결성을 확인하고, 테스트는 운영과 같은 PostgreSQL에서 돌립니다.
해결한 문제
적재 성능
행 단위 upsert가 원격 DB 왕복에 막힌 문제
기초 데이터 적재 200초에서 71초, 경기 13,724건 무인 적재
문제
행마다 upsert하자 원격 DB 왕복 때문에 5초 트랜잭션 한도에 걸렸습니다. 20개 팀을 저장하는 데만 약 4초가 걸려, 수십만 행 규모의 백필은 불가능했습니다.
원인
행마다 약 60ms의 네트워크 왕복이 생겼고, ORM의 upsert는 경우에 따라 조회와 저장 두 번의 쿼리로 나갔습니다.
해결
테이블당 한 문장의 INSERT … ON CONFLICT DO UPDATE로 묶는 batchUpsert를 만들고, 충돌 키 중복 제거, 명시적 타입 변환, 파라미터 65,535개 한도에 맞춘 분할, COALESCE로 기존 값 보호까지 처리했습니다.
DB 리전을 앱 서버와 같은 서울로 옮겼습니다.
결과
배치 upsert로 대회·시즌 하나당 쿼리가 3문장으로 줄었고, 리전 이전과 합쳐 기초 데이터 적재 시간이 200초에서 71초로 줄었습니다. 경기 13,724건과 상세 백필을 무인으로 끝냈습니다.
동시성
라이브 스코어 역행과 동시 저장 충돌
조건부 UPDATE로 역행 쓰기 차단, advisory lock으로 동시 저장 오류 제거
문제
15초 주기 라이브 폴러와 매일 도는 일정 수집 잡이 같은 경기 상태를 덮어써, 진행 중인 스코어가 이전 상태로 되돌아갈 수 있었습니다. 즐겨찾기를 동시에 저장하면 unique 충돌로 500 오류가 났습니다.
해결
상태 순위와 경과 시간을 WHERE 절에서 비교하는 조건부 UPDATE 한 문장으로 바꿔, 읽고 쓰는 사이의 경합 없이 역행하는 쓰기를 막았습니다. 쓸 때마다 data_version을 올립니다.
잡마다 matches 테이블에서 쓸 수 있는 컬럼을 나눠 서로 덮어쓰지 않게 했습니다.
즐겨찾기 저장은 트랜잭션 안에서 사용자 단위 pg_advisory_xact_lock으로 직렬화했습니다.
결과
막힌 쓰기는 /health에 차단 건수로 집계되고, 동시 저장 시나리오는 테스트로 검증합니다.
배포
재시작 루프와 롤백본 유실
헬스체크를 통과한 버전만 롤백본으로 남기도록 배포 스크립트 수정
문제
필수 환경변수 검증을 추가해 배포했는데 운영 서버에 그 값이 없어 서비스가 재시작을 반복했습니다. 이어서 재배포하자 깨진 빌드가 롤백본을 덮어써 되돌릴 버전이 사라졌습니다.
해결
환경변수 템플릿에 필수 항목을 추가하고, 배포 스크립트가 헬스체크를 통과한 버전만 롤백본(dist.prev)으로 남기도록 바꿨습니다.
결과
실패한 배포가 마지막 정상 버전을 지울 수 없게 됐습니다.
운영
백업과 복원
매일 04:00(KST)에 pg_dump로 백업해 S3에 올리고, 최근 8개와 월별 12개를 보관합니다. 일회용 컨테이너에 복원해 원본과 행 수를 대조하는 리허설에서 31개 테이블 93,337행이 두 번 연속 일치했습니다.
CI
빈 PostgreSQL 16에 마이그레이션을 적용하고, 부분 인덱스 확인, 타입 검사와 린트, 단위 테스트 약 300개와 E2E 테스트 약 200개, 고아 행 검사를 통과해야 병합됩니다. 작업 브랜치에 보호 규칙을 걸고 PR 148개 중 144개를 병합했고, 10월 16일 dev에서 main으로 첫 릴리즈를 냈습니다.
AI 활용과 검증
Claude Code로 개발하되 pre-commit 훅(널 바이트, 인코딩, API 키 유출 차단), 브랜치 보호, CI 필수 검사로 결과물을 검증했습니다. 어시스턴트는 숫자를 만들지 않고 서버의 결정적 도구만 호출하며, 답에 기준 시각과 근거를 붙입니다.
운영 중 수정
id가 없는 선수 데이터가 다른 선수와 합쳐지는 것을 막고, 상세 백필이 같은 경기에서 끝없이 재시도하지 않게 경기 단위 재시도 상한을 두는 등 운영 중 찾은 수집 문제를 고쳤습니다.
수년간 운영된 Spring Legacy와 PostgreSQL 구조를 화면, 쿼리, 테이블 순으로 거슬러 올라가며 분석해 오류를 고쳤습니다. 데이터를 갱신한 뒤 통계와 화면에서 드러나는 오류도 확인해 수정했습니다.
데이터 갱신
국가중점데이터로 개방되는 도시재생 지표의 연례 갱신을 맡았습니다. 도시재생법 시행령 제17조의 활성화지역 지정 기준을 지도에서 진단하는 활성화지역진단 기능에 쓰이는 지표 다섯 개(과거대비 인구변화, 최근 인구변화, 과거대비 사업체변화, 최근 사업체변화, 노후건축물비율)를 가공했고, 공공데이터와 GIS 데이터를 정기적으로 처리했습니다.
연도별 레이어 운영
연례 갱신마다 지표와 사업 데이터를 연도별 ArcGIS 레이어로 만들어 배포하고, 화면 코드가 새 연도 레이어를 보도록 전환했습니다.
진단 로직과 데이터 검증
활성화지역진단의 부합 판정에서 경계값, 값이 없는 지역, 지표값 설정 처리 오류를 고쳤습니다. 갱신 뒤에는 시군구·읍면동·격자 값과 지도·표·차트의 건수를 대조해 어긋난 곳을 바로잡았습니다.
공간정보
지자체가 제출한 사업경계 레이어를 하나로 통합하고, 좌표계 불일치와 위상 오류를 QGIS 검증 도구로 확인해 보정했습니다. 처음 다룬 GIS는 사내 문서와 QGIS 실무자 커뮤니티에 질문하며 익혔습니다.
조회 성능과 공공데이터
진단 대상이 많을수록 늘어나는 지도 조회를 조회 조건과 반환 항목을 줄여 개선했습니다. 체육시설·도서관 같은 기초생활인프라 공공데이터를 좌표로 변환하며 실패와 중복 데이터를 정리했습니다.
해결한 문제
대량 데이터
건축물대장 3,000만 건 갱신 작업 재설계
멈춰도 처음부터 다시 돌리지 않게 됐고, 다음 해에도 그대로 쓸 수 있게 남겼습니다
문제
전국 건축물대장(약 3,000만 건 CSV)으로 노후건축물 비율 같은 지표와 용도·구조·연도별 GIS 레이어를 매년 새로 만들어야 했습니다. 노후건축물 비율은 활성화지역 지정 기준에 쓰이는 지표라 매년 같은 기준으로 다시 만들 수 있어야 했습니다. 전년도 코드는 그대로 돌지 않았고, 실패하면 어디서 왜 멈췄는지 알기 어려웠습니다.
원인
파일이 커서 한 번에 읽어 처리하기 어려웠습니다.
건축물대장 데이터셋 구성이 바뀌어 전년도 코드와 맞지 않았습니다.
지표마다 코드가 따로 실행되고 실패 기록이 남지 않아, 멈추면 처음부터 다시 돌려야 했습니다.
해결
지표별로 필요한 컬럼만 골라 읽는 전처리 단계를 만들었습니다.
흩어져 있던 실행 코드를 하나의 실행 흐름으로 합쳤습니다.
처리 단위를 나누고 적재 전에 검증해, 다시 실행해도 결과가 같게 했습니다.
실패하면 원인을 로그로 남기고, 마지막 저장 시점부터 이어서 처리하게 했습니다.
건축물대장 CSV약 3,000만 건
컬럼 선별 읽기지표별 필요한 컬럼만
분할 처리와 검증실패 원인 로그, 저장 시점 기록
적재와 산출지표, GIS 레이어
이전준비
이후준비
칸 하나가 처리 단위이고, 칸 아래 표시가 저장 시점입니다.
같은 작업이 중간에 실패했을 때 두 방식이 어떻게 다시 도는지 비교합니다.
결과
필요한 지표와 레이어를 산출했고, 중간에 멈춰도 3,000만 건을 처음부터 다시 돌리지 않게 됐습니다. 다음 갱신에서도 그대로 쓸 수 있게 정리해 두었습니다.
기준 정하기
지자체마다 다른 공간정보 제출 형식 통일
지자체마다 다르게 들어오던 자료를 같은 기준으로 관리하게 됐습니다
문제
지자체마다 사업경계 파일의 형식과 좌표계가 달라, 자료를 모을 때마다 변환하고 확인하는 데 시간이 걸렸습니다.
원인
제출 기준이 없어서 지자체마다 쓰던 형식 그대로 제출했습니다.
해결
입력 데이터 표준을 정의한 제출 규격과 작성 가이드를 만들어 지자체에 배포했습니다.
이미 받은 파일은 좌표계를 하나로 변환하고 데이터 형식을 맞춰 하나의 레이어로 통합했습니다.
결과
지자체마다 다르게 들어오던 자료를 같은 기준으로 관리할 수 있게 됐습니다.
기준 정하기
행정구역이 바뀌어도 이어지는 연도별 지표
통합, 분리 같은 변경 유형별로 처리 기준을 세웠습니다
문제
지표를 매년 갱신하는데, 과거대비 인구변화처럼 여러 해의 값을 비교하는 지표는 기준 행정구역이 통합되거나 분리되면 이전 값과 비교할 수 없었습니다.
해결
통합, 분리 같은 변경 유형별로 처리 기준을 세워 갱신 작업에 적용했습니다. 반복되는 데이터 작업일수록 기준을 먼저 정해 두어야 매번 같은 결과가 나온다는 것을 배웠습니다.
장애 원인 추적
지도 레이어를 골라도 안 보이던 오류
id 값을 바로잡은 뒤에도 남은 증상을 다시 추적해, 필터 컬럼에 인덱스를 줬습니다
문제
지도에서 레이어를 선택해도 표시되지 않았습니다. 겉으로는 하나의 증상이었지만 원인이 두 가지 겹쳐 있어, 하나를 고친 뒤에도 같은 증상이 남았습니다.
원인
개발자 도구 네트워크 탭에서 요청을 확인해 보니, 지표를 갱신하면서 레이어 id 컬럼 값과 요청에 보내는 값이 달라져 있었습니다. 이를 고쳐 보고한 뒤에도 테스트 담당자가 여전히 안 보인다고 해 다시 확인하니, 레이어 데이터가 커져 검색이 오래 걸리다 보니 표시되지 않는 것처럼 보인 것이었습니다.
해결
id 값은 화면 코드에서 갱신된 지표에 맞춰 고쳤습니다. 느린 검색은 ArcGIS로 배포한 레이어 데이터에 인덱스를 추가해 풀었습니다. 지도에서는 사업정보, 지역현황 같은 주제 아래 연도와 부처 분류 등 여러 조건으로 레이어를 골라 보게 되어 있어, 이 필터가 조회 조건으로 쓰는 컬럼에 인덱스를 줬습니다.
결과
정확히 측정하지는 않았지만, "왜 안 나오지?" 하던 레이어가 선택하자마자 보이는 수준이 됐습니다.
팀 프로젝트코리아IT아카데미2024.04 – 2024.053인, 팀장Java 11, Spring Boot 2.6, MyBatis, MySQL, React 18, Docker, Nginx, GitHub Actions, AWS EC2와 S3
과외나무 LessonTree
학생과 선생님을 이어 주는 과외 매칭 웹 서비스입니다. 팀장으로 이슈와 PR 흐름을 운영했고, 조회·검색 API와 무중단 배포 파이프라인을 직접 만들었습니다.
이슈 → 브랜치 → PR → 팀장 병합 흐름을 운영했습니다. 두 저장소 PR 172개 중 65개를 작성하고 152개를 병합했습니다.
무중단 배포
main에 반영되면 GitHub Actions가 빌드한 이미지를 운영 중이 아닌 쪽 포트에 띄우고, 헬스체크를 통과하면 Nginx 대상을 바꿉니다. 적용 하루 전에 별도 저장소에서 같은 구조를 먼저 검증했습니다.
GitHub Actions에서 빌드
시크릿 주입설정 파일 생성
Maven 빌드JDK 11
Docker 이미지Docker Hub에 push
AWS EC2에 배포
현재 색 확인/server/env
반대 색 기동8080/9090 포트
헬스체크10초 간격, 최대 3회
Nginx 전환설정 갱신, reload
이전 컨테이너중지, 삭제
blue(8080)가 요청을 받는 중에 main에 새 버전이 반영된 경우입니다.
다중 조건 검색
지역, 과목, 요일, 학생 유형 조건을 MyBatis 동적 SQL로 조합해 공고 ID만 먼저 뽑고, 그 ID로 과목·요일 같은 1:N 상세를 한 번에 조회했습니다. 조건 필터가 상세 목록을 잘라내지 않고, 비활성 회원의 공고는 빠지게 했습니다.
돌아보면
신고와 계정 비활성화를 기획 단계에서 빠뜨려 개발 중에 테이블과 컬럼을 추가하고 계정 기능을 고쳐야 했습니다. 그 뒤로는 기능 목록을 먼저 확정하고 DB를 설계합니다. 배포 워크플로는 PR 이벤트에서도 배포 단계가 돌도록 되어 있었는데, 지금이라면 push 이벤트로만 제한하겠습니다.
경력과 학습
경력
2024.09 – 2025.08
도시재생 종합정보체계 유지관리 사업주택도시보증공사 발주, 아이티커넥 소속 프리랜서(주임), 응용SW개발, 12개월
프로젝트
2026.09 – 2026.10
FantaSteel ERP포스코 K-뉴딜 아카데미 팀 프로젝트(5인). 서버 공통 기반, 구매·Message → ERP 모듈
2026.08 – 2026.10
PitchLog League개인 프로젝트. 축구 데이터 서비스의 수집·API·운영을 혼자 맡음
2024.04 – 2024.05
과외나무 LessonTree팀 프로젝트(3인) 팀장
학습
2026.08 – 현재
포스코 K-뉴딜 아카데미LLM 기반 스마트팩토리 AI Assistant 개발 과정, 수강 중
2026 – 현재
AI-Byte-Club 스터디『주니어 백엔드 개발자가 반드시 알아야 할 실무 지식』 챕터별 토론. DB 인덱스, 동시성, 인증과 암호화
2024.12 – 2025.05
백준 알고리즘 스터디같은 문제를 Java와 JavaScript로 풀며 주 단위 마감 유지
2023.12 – 2024.05
코리아IT아카데미Java·Spring Boot 기반 웹 개발 과정(빅데이터·AI 헬스케어 플랫폼). Java, Spring Boot, React, MySQL, AWS